みなさん、こんにちは。
今回は、ありそうで意外とない「Web会議を簡単に録音する」ためのツール「OtoMix」を個人開発したので、その記録を書きたいと思います。
- GitHub: taoman26/OtoMix
- リリース (v0.1.2): v0.1.2 Release
なぜ、このツールを作ったのか
自分が参加するWeb会議の録音※って、やろうとすると意外とひと手間かかります。
- 自分の声は マイク から入る
- 相手の声は スピーカーから出る音(システム音声) で、マイクとは別系統
この2つを1つの音声ファイルにまとめようとすると、OBS Studioのような重量級の配信ソフトを入れたり、別のミキシングソフト、あるいは仮想オーディオケーブル(以前、デジタル聴診器の録音方法で触れました)を経由させたり……と、大げさな環境構築が必要になりがちです。「ただ会議を録音したいだけなのに!」と、いつもモヤモヤしていました。
そこで、次のようなシンプルで軽い条件を満たすツールが欲しいと思ったのが開発のきっかけです。
- マイクとシステム音声を 1つのファイルに混ぜて 録音できること
- 面倒なミキシングアプリを別途入れなくていいこと
- OBSよりずっと軽いこと
- Windows でも Ubuntu などの Linux でも動くこと
※当たり前のことですが、WEB会議の録音は参加者の同意をとって行ってくださいね。
作ったツール「OtoMix」 の概要
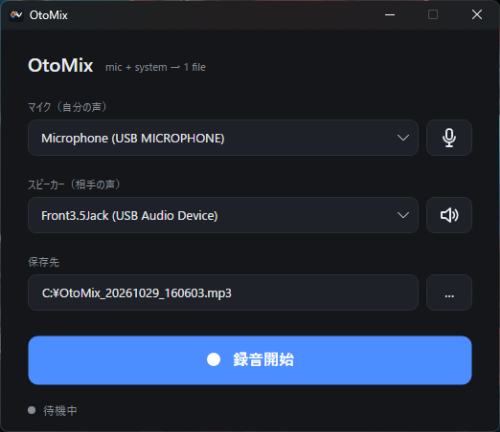
画面はシンプルに1枚のみです。マイクとスピーカーを選び、保存先を決めて「録音ボタン」を押すだけ。
- 出力フォーマット
- MP3 または WAV(48kHz・ステレオ)
- 便利機能
- 録音中の経過時間表示、および「マイクだけ」「相手の声だけ」を切り替えられる ミュートボタン(録音中も変更可能)
- 技術スタック
- Avalonia UI (C# / .NET 8) を採用し、音声エンコードは裏で FFmpeg に任せています。
AIと一緒に、小さく作って、必ず動かす
今回の開発は Claude Code と一緒に進めました。その際、自分の中で3つのルールを設けています。
- 画面デザインを先にPythonで画像として作る。それを
design.mdに落とし込んでから実装する。 - 技術スタックや設計方針は
CLAUDE.mdにまとめ、毎回のセッションで必ず読み込ませる。 - 機能は小さく1つずつ。実装したら必ず実際に動かして検証し、結果を報告させてから次に進む。「実装しました」だけで終わらせない。
特に3つ目がめちゃくちゃ効きました。AIは「できました」と言うのが得意ですが、音声まわりは実際に動かしてみないと「音が入っていなかった」ということが普通に起きます。「実際にファイルを録音して、音量を測って確認する」を毎ステップ義務づけたおかげで、のちに直面する大きめの設計変更にも早く気づくことができました。
開発時の方針転換 – FFmpegの amix をやめた話
最初の設計では、FFmpeg にマイクとシステムの2つの入力を渡し、-filter_complex amix で混ぜる方式を考えていました。しかし、実際に作りながら大きな2つの壁にぶつかりました。
壁1. ミュートが即時に効かない
「録りたくない側を無音にする」ミュート機能を、録音中の FFmpeg に対して実行時に行おうとしました。FFmpeg に標準入力からコマンドを送る仕組みはあるのですが、実測すると 反映までに 0.3〜0.5 秒ほどのタイムラグ がありました。会議の録音で、ミュートボタンを押した直後の発言が入ってしまうのは致命的です。
壁2. Windows でシステム音声が録れない
Windows の dshow 入力には、スピーカーの音をそのまま取得する手軽な標準手段がありません。「ステレオ ミキサー」を有効にしてもらうか、仮想オーディオケーブルを入れてもらう必要があり、「別アプリ不要」というコンセプトに反してしまいます。
解決策は、取得もミックスも「アプリ側」で行う
そこで、思い切って次のような構成に変更しました。
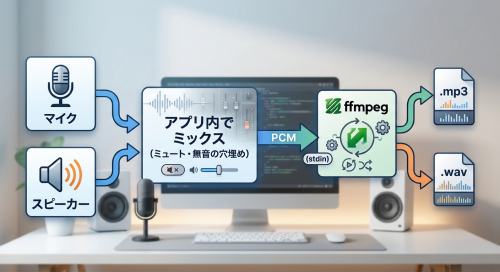
- 音の取得はアプリ側で行い、FFmpeg はエンコード専用に徹してもらう。
- Windows は WASAPI(NAudio)を使用。マイクは通常キャプチャ、スピーカーはループバックで取れるため、仮想ケーブルが不要に。
- Linux は
parec(PulseAudio / PipeWire互換)で取得。 - 取得した音を 48kHz・ステレオ・float に揃えてアプリ内で足し合わせ、PCM として FFmpeg の標準入力へ流し込む。
- ミュートは、入力ごとの音量をその場で 0 にする(10ms のフェード付き)。
結果として、ミュートの遅れは約 50msまで縮まり、ボタンを押した瞬間にパッと効くようになりました。さらに、両 OS で同じミキサーロジックが動くため、コードもかなりスッキリ共通化できました。
当初の「amix で混ぜる」という要件からは外れましたが、「別ソフト不要で1ファイルに混ぜる」「即座にミュートできる」という目的には、こちらのほうが圧倒的にマッチしていました。
地味にハマったポイントたち
開発中、次のような細かい罠にもいくつか遭遇しました。
- システム音声は「無音のときデータが来ない」
- WASAPIループバックは、何も再生されていないとデータが流れてきません。「届いた分をそのまま書き込む」実装にすると、無音区間でタイムラインが詰まり、ファイルが実際より短くなってしまいます。そのため、一定の時間間隔でタイマーを回し、足りない分は無音データで埋める仕組みにしました。
- 終了時は「qを送る」ではなく「入力を閉じる」
- 録音を止めるときに FFmpeg を強制終了するとファイルが壊れます。最初は
qキーを送る方式を考えていましたが、PCMをパイプで流す構成に変えたので、標準入力を閉じて(EOF)、エンコードをキレイに終わらせてから終了する方式に変更しました(5秒待っても終わらない時だけ強制終了)。
- 録音を止めるときに FFmpeg を強制終了するとファイルが壊れます。最初は
- WSL から起動した Windows アプリは画面が出ない
- 開発は WSL2 上で行っており、Windows 側の動作確認はWSLからWindowsの
.exeを叩いて行いましたが、この方法だと「Session 0」という画面を持てないバックグラウンド領域で動いてしまい、メモ帳すら開きません。そのため、Windows側の検証は GUI なしのコンソール検証ツールを作り、volumedetectやsilencedetectを使って「狙った位置に音が入っているか」「ミュート区間がしっかりデジタル無音(約 -91 dB)になっているか」を数値で検証しました。
- 開発は WSL2 上で行っており、Windows 側の動作確認はWSLからWindowsの
注意点と使い方
開発初期段階でまだ長時間の耐久テストなどが十分ではないため、以下の点にご注意ください。
- 長時間録音すると、マイクとシステム音声のタイミングが少しずつズレる可能性があります。
- Windows版の
.exeはコード署名をしていないため、初回起動時にSmartScreenの警告が出ます。 - 録音ボタンを押してから実際に録音が始まるまでに約1秒のタイムラグがあります。
導入方法
GitHub にソースやテスト、各種ファイルをアップしており、Windows版(zip)と Linux版(tar.gz)をチェックサム付きでリリースしています。 動作にはFFmpegが必要です(PATHに通しておく必要があります)。Linux の場合はさらに pactl と parec が必要になります。
OtoMix は小さなツールですが、「会議の録音を自分の知識資産にする」ための第一歩として作りました。Web会議の録音環境に困っている方は、ぜひ一度試してみてください。
「ここが使いやすかった」「この環境でうまく動かなかった」といったフィードバックも大歓迎です。
- GitHub: taoman26/OtoMix
- リリース (v0.1.2): v0.1.2 Release
録ったあと、どうするか
OtoMix によって、会議の音を手軽にきれいに1ファイルへ残せるようになりました。しかし、ここで新たな問題が生まれます。
「録音は保存されている。でも、検索できない。」
数ヶ月後に「あのときKPIの話をしていたのは、どの会議のどの部分だっけ?」となったとき、議事録のテキストには残っていない雑談の中の重要な一言は、膨大な音声データの中に眠ったままになってしまいます。探せない録音は、存在しないのと同じですよね。
というわけで、次回はこの問題意識から作った「録音アーカイブ検索ツール」について書きたいと思います。
最後までお読みいただきありがとうございました。
それでは、よいWeb会議ライフを!