みなさん、こんにちは。
ここ数年で、録音データを取り巻く環境は劇的に変わりました。Teams、Zoom、Google Meetなど、会議はほぼ毎回のように録画・録音されるのが当たり前になりました。その流れで、先日もWEB会議を簡単に録音できる「OtoMix」をご紹介しましたよね。
さらに Whisper の登場によって文字起こしのコストはほぼゼロに近づき、現在では以下のような流れがすっかり定着しています。
- 会議
- 録画・録音
- AI文字起こし
- AI要約
- 議事録の完成!
……一見すると完璧なフローに見えますが、ここで一つ大きな疑問を投げかけたいと思います。
「議事録を作ることがゴールになっていないか?」
「議事録だけで、本当に録音データの価値を使い切れているのだろうか?」
今回は、そんな問題意識から作ったツールのお話です。
議事録は「要約」であって、文脈が抜け落ちている
現在のAI議事録ツールのほとんどは、「録音から議事録を作る」ことを目的にしています。
例えば、1時間の濃密な技術会議があったとしましょう。一般的な議事録に残るのは、だいたい次のような項目です。
- 決定事項
- ToDo
- 主要なポイント
つまり、議事録とは「会議の『結果』をまとめた圧縮データ」に過ぎません。しかし、実際の録音データには、もっと大量の貴重な情報が眠っています。
- なぜその結論に至ったのか?
- 誰が反対していて、どんな懸念を示していたのか?
- どんな代替案が検討されたのか?
- どこで議論が最も盛り上がったのか?
- どのような文脈(ニュアンス)でその発言が出たのか?
これらは、議事録として要約される瞬間にほとんど捨てられてしまいます。
もちろん、議事録自体は重要です。でもそれはあくまで録音の「要約」に過ぎず、言外にある文脈や背景はすっかり消失してしまっているんですよね。
増え続ける音声、しかし「探せない」ジレンマ
しかも、私たちが抱える音声データの量は昔とは比べものになりません。
- 会議の録音
- 勉強会のアーカイブ
- お気に入りの Podcast
- Voicyや stand.fm
- YouTubeの音声
- 個人のボイスメモ
個人が保有する音声コンテンツは膨らむ一方です。しかし、数ヶ月経ってから、
- 「あのプロジェクトAの課題について話していた回はどれだっけ?」
- 「KPIについて議論した会議はいつだっけ?」
- 「DockerからPodmanへ移行する話が出たのはどこだっけ?」
となったとき、探し出す手段がほとんどありません。
議事録が残っていても、雑談や議論の途中で飛び出した重要な情報は記載されていないことが多い。「雑談のついでに話したあのアイデア、確かに録音には残っているのに見つからない……」という経験が誰しもあるはずです。
録音は保存されている。でも検索できない。
これは、どこか初期のWebに似ている気がします。
WebにGoogleがあったように、音声にも検索が必要だ
かつて、Webページが大量に存在するようになっても、当初は中身を探す有効な手段がありませんでした。それを解決したのがGoogleのインデックス化です。
- ページ ➔ インデックス化 ➔ 検索
この構造がWebを救いました。同じように、録音データの世界にも、
- 録画・録音 ➔ 文字起こし ➔ インデックス化 ➔ 検索
というパイプラインが必要なのではないでしょうか?
ちなみに、意外と見落としがちなのがYoutubeやPodcastアプリの弱点です。YoutubeやPodcastアプリにも検索機能はありますが、その多くは「番組名」「エピソード名」「説明文」が対象です。
私たちが本当に探したいのは、「エピソードの中で何を話したか(中身)」のはず。
もし、
「KPI」 と入力すると、
👉 Episode 51 (17:23)
👉 Episode 94 (42:18)
👉 Episode 131 (08:55)
とヒットして、そこからダイレクトに再生できる。
そんな体験、今のアプリではなかなか見かけませんよね。
しかも面白いことに、動画よりも音声の方が検索しやすいという特徴があります。動画はテロップやBGM、画面上の情報がノイズになりがちですが、音声は「純粋な発言そのものをテキスト化できる」ため、テキストインデックスとの相性が極めて良いのです。さらに、会議の録音であれば、動画でありがちなBGMの歌詞やCMのセリフを誤って文字起こししてしまう心配もありません。
さらに言えば、録音データは社内会議や顧客との打ち合わせ、研究インタビュー、個人的なメモなど機密性が高いデータでもあります。「クラウドへ簡単にアップロードしたくない」というニーズも根強くあるため、
- ローカル環境で ➔ 文字起こし ➔ インデックス化 ➔ 検索
という仕組み自体に、大きな価値があると考えています。
録音は「保険」ではなく「知識資産」だ
現在、多くの人は録音を「何かあったときの保険(聞き返すため)」として保存しています。
しかし現実には、数百時間分の録音を後からすべて聞き返す人なんてほぼいません。「探せない録音は、存在しないのと同じ」です。
だからこそ、録音は保険ではなく「知識資産」だと捉えるべきです。そして知識資産である以上、自由自在に検索できなければ意味がありません。
自作ツール「AudioKnowledgeExplorer」を作りました
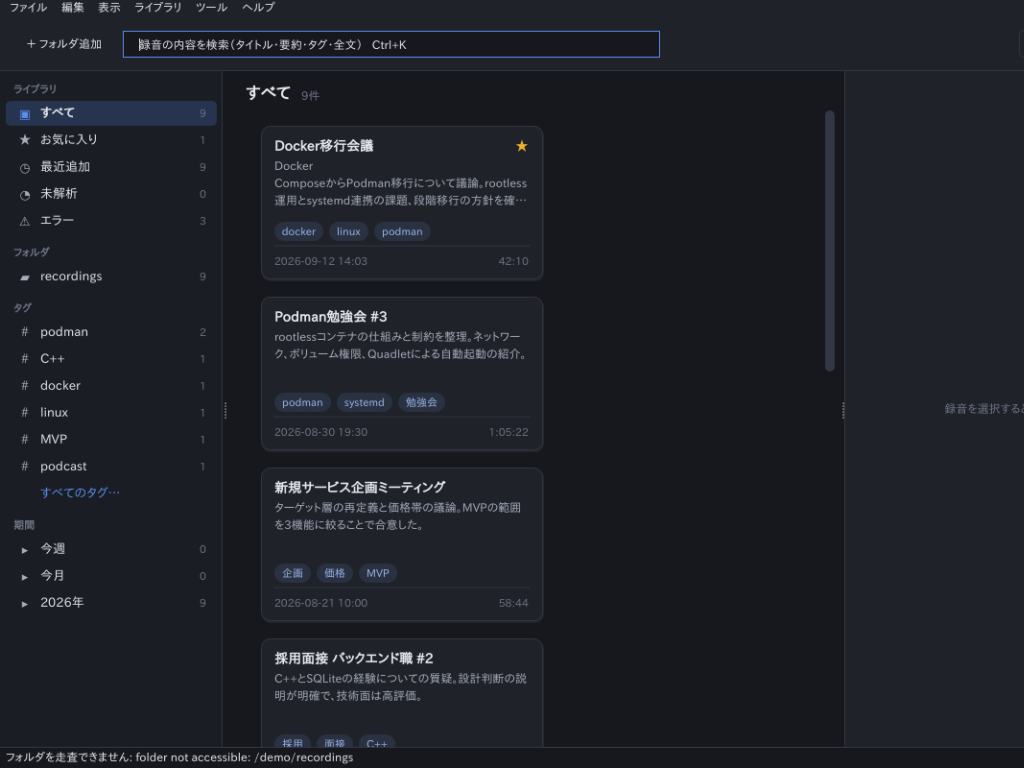
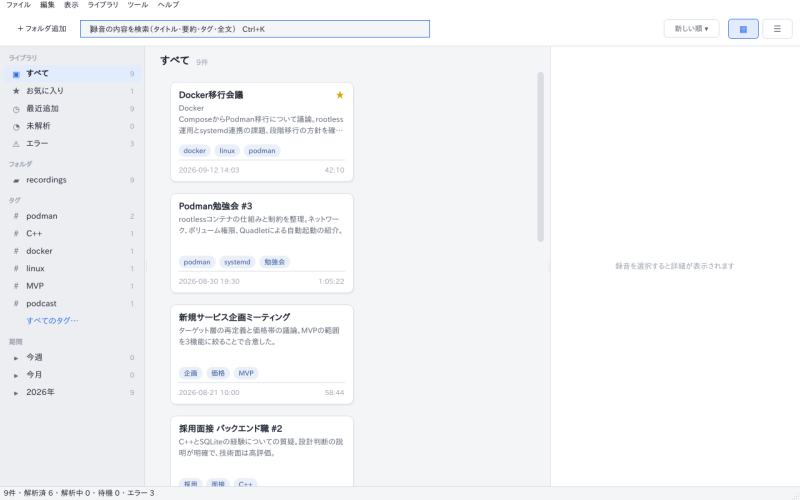
こうした問題意識から、私は AudioKnowledgeExplorer というツールを開発して公開しました。
GitHub:taoman26/AudioKnowledgeExplorer
リリース (v0.1.0): v0.1.0 Release
これは、よくあるAI議事録ツールではなくて、「録音アーカイブ検索ツール」です。
目的は、
- 録音する
- 文字起こしする
- インデックス化する
- 検索する
- 該当発言へジャンプし、その位置から再生する
この一連の流れをシームレスに実現することです。
例えば「KPI」と検索すれば、数年前のPodcastでも、勉強会の録音でも、過去の会議でも、その単語が話されたピンポイントの場所が見つかり、その瞬間から再生できます。
一言で言えば、録音データを「検索可能な知識資産」に変換するためのツールです。前回記事にした「OtoMix」と組み合わせれば、録音から文字起こし、インデックス化まで、面倒な作業がほぼ全自動で完了します。
「録音を聞き返す時間」をゼロにし、「必要な文脈に一瞬でアクセスする」体験が得られるのです。GitHubでオープンソースとして公開していますので、興味のある方はぜひ覗いてみてください!
GitHub:taoman26/AudioKnowledgeExplorer
リリース (v0.1.0): v0.1.0 Release
文字起こしの「次の段階」へ
AIによる文字起こし自体は、いまや珍しい技術ではなくなりました。
だからこそ、これからは「文字起こしされた内容をどう活用するか」が重要になってきます。録音アーカイブを知識資産として再利用できるようにするには、「録音を検索できること」がどうしても必要です。
今はまだ、この必要性が広く認識されていないフェーズかもしれません。しかし、会議もPodcastも録音が当たり前になった世界で次に求められるのは、「録音すること」ではなく「探せること」ではないでしょうか?
みなさんは、過去の録音データをどう活用していますか? ぜひご意見やアイデアをGitHub Issues で教えてください!
本日も最後までお読みいただきありがとうございました。
それでは、よい会議ライフを!
「自分も何か作ってみたい」と思われた方、そのアイデア、頭の中で寝かせておくのはもったいないかもしれません。
ビューローみかみでは、構想段階の壁打ちからPoC・実装・現場導入まで、現場で「使い続けられる」ものづくりを支援しています。
アイデアを短期間で「動くもの」にし、PoCで終わらせず、実運用まで伴走します。まずは「これ、作る価値ありますか?」という壁打ちからでも大歓迎です。
▶ PoC・MVP開発サービスの詳細はこちら
気になることがあればお気軽にご相談ください。